三个计算域
关节伺服 1 kHz 不能和推理同芯片,这是安全约束。
上身 AI 推理域、上身交互域、下身硬实时控制岛,三者物理隔离。 AI 故障时,实时岛仍能维持站立或抱死。
AI 推理域
U 芯片 + 32 GB LPDDR5X,跑 50B 模型的低比特稀疏推理;和交互域通过 PCIe 连接。
交互域
CPU / GPU 做显示、语音、感知后处理与调度,10–15 W,可降频。
硬实时控制岛
MCU / FPGA 跑 1 kHz 控制环与 EtherCAT,和 AI 域没有共享时钟、没有共享电源域。
U 芯片
算力是保险,带宽是吃饭。
50B 模型每帧都要把权重读一遍。真正决定帧率的是内存带宽,不是 TOPS—— 性能模型显示算力利用率只有 1.16%。
| 指标 | 值 |
|---|---|
| INT8 密集算力 | 60 TOPS |
| INT8 稀疏(2:4)有效 | 120 TOPS |
| INT4 有效 | 240 TOPS |
| 内存 | 32 GB LPDDR5X |
| 带宽 | 384-bit · 300 GB/s |
| 片上缓存 | 16 MB SRAM |
| 主机接口 | PCIe Gen4 ×4 |
| 工艺 / 面积 | 12 nm · ≈ 35 mm² |
| 功耗 | ≤ 25 W |
| 50B 权重形式 | 每帧读取 | 300 GB/s 下帧率 |
|---|---|---|
| INT8 密集 | 50 GB | ≈ 6 Hz |
| INT4 密集 | 25 GB | ≈ 12 Hz |
| INT4 + 2:4 稀疏 | 18.75 GB | 13.9 Hz |
主计算板
200 × 150 mm,双计算区,先兼容过渡件。
板子上给自研 U 预留了 B 区;在芯片回来之前,A 区上 Jetson Orin NX 先跑通用计算, B 区插 Hailo-8 做 AI 加速。这样系统、散热、结构可以先验证一轮。
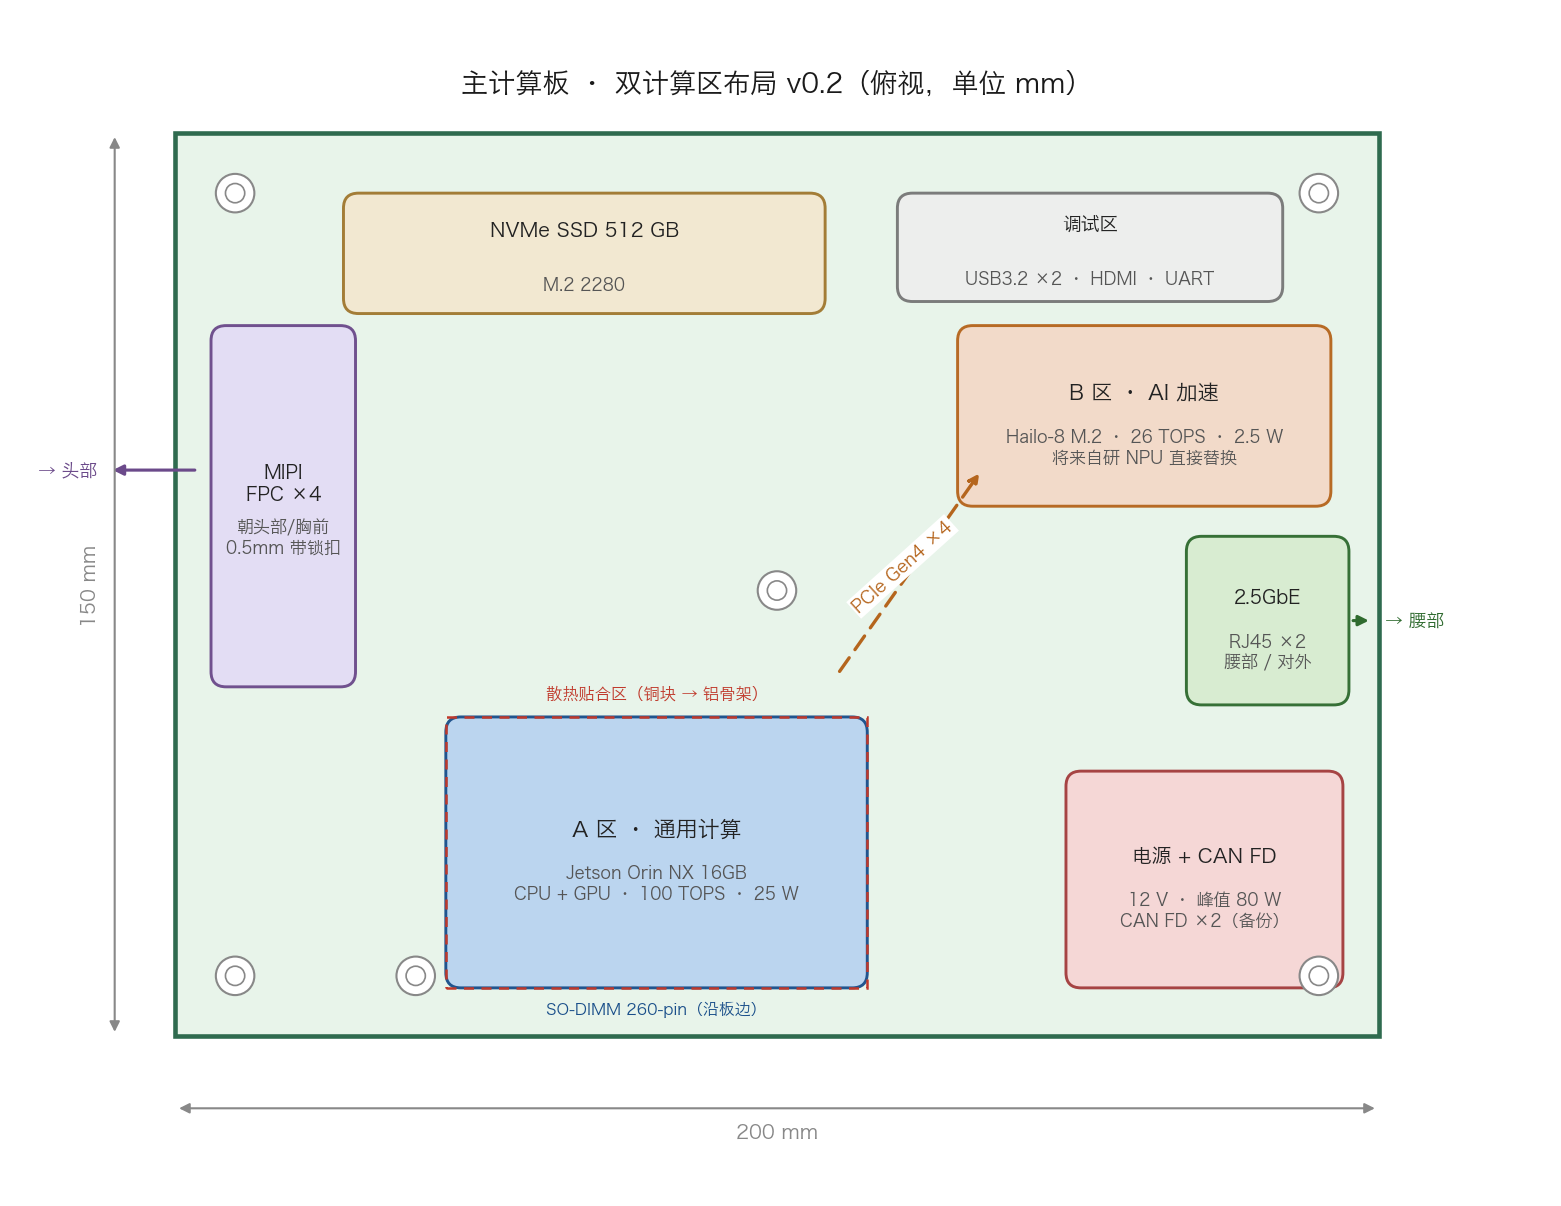
| 项目 | 值 |
|---|---|
| 尺寸 / 叠层 | 200 × 150 mm · 6 层 · 1.6 mm |
| A 区 | Jetson Orin NX 16GB(CPU+GPU,25 W) |
| B 区 | Hailo-8 M.2(26 TOPS / 2.5 W)→ 将来换 U |
| 网络 | 2.5GbE ×2(腰部 / 对外) |
| 实时总线 | CAN FD ×2(隔离) |
| 相机 | MIPI FPC ×4 · GMSL2 ×2 |
| 供电 | 12 V · 峰值 80 W |
已产出:架构级原理图(18 模块、网络表已定)、PCB 板框 + Gerber(6 层全出)、3D 渲染验证。 还没做:上电、信号完整性、热实测。
- 01
实时岛与 AI 域物理隔离,推理卡顿不得影响 1 kHz 控制
- 02
急停走硬线,不经过任何软件路径
- 03
腰部快拆是单点故障源,按 2.5GbE + 工业连接器设计
功耗、成本与时间
45 W 的预算,几乎没有余量。
| 部分 | 功耗 | 备注 |
|---|---|---|
| U 芯片 | ≤ 30 W | 内存 12 + 计算 15 + 其他 3 |
| 通用计算 | 10–15 W | 可降频 |
| 传感器 / 网络 | 5 W | — |
| 余量 | 0–5 W | 偏紧 |
| 计算合计 | ≤ 45 W | 整机 255–455 W |
| 项目 | 成本 |
|---|---|
| 主计算板(小批,单板) | ≈ ¥6,000 |
| FPGA 原型 | ¥10–30 万 |
| 12 nm MPW 流片 | ¥350–700 万 |
| 全掩膜量产 | ¥2,000 万+ |
| 封装(FCBGA) | ¥50–100 / 颗 |
时间线
主板打样 1–2 月 · RTL 3–6 月 · FPGA 3–6 月(能效 < 5 TOPS/W 即停)· 12 nm 首片 6–9 月 · 量产 +12–18 月(需融资)。
风险
七条风险:一条致命,三条高。
致命 / 高
12 nm 产能拿不到:中芯 + 台积电 16 nm 双路径,提前锁定。
能效达不到 15 TOPS/W:FPGA 阶段设停止判据(< 5 TOPS/W 即停)。
软件栈 / 编译器:不自研编译器,用 LLVM + OpenCL。
中 / 高
50B 带宽不够:已算过,需 INT4 + 2:4,否则要上 HBM / 7 nm。
稀疏化精度掉太多:QAT + 增长架构天然稀疏。
45 W 预算无余量:采集子系统独立电源域。
资金链:分阶段里程碑融资,流片是最贵的一步。
算力线的专题文档暂不对外发布;这里只保留可公开复述的规格与结论。